摘要
针对蛋白质靶点设计适配分子是一项具有挑战性的任务。近年,深度生成模型成功应用于新药分子设计。从原子等级构建分子的模型容易生成不符合化学规律的结构;开发容易合成、亲和力高的分子设计模型依然是该领域的重要研究内容。本文开发了一种面向靶点口袋的药物分子设计模型,BFMOL。模型由两个编码器和一个门控自注意力解码器构成;编码器用于提取靶点和配体分子的特征,解码器实现两种特征的关联并解码为分子片段概率,进而生成配体分子。模型通过BRICS方法对分子进行片段化,并在原子、残基和残基间三个层次对靶点口袋进行特征化。结果表明,在Crossdocked数据集上,BFMOL设计的分子,其平均合成可及性得分达到0.769,平均类药性得分达到0.607,高于PMDM模型(0.611和0.594)。在针对激酶类靶点的分子设计中,模型生成的分子具备更多双六元环结构,具有激酶抑制剂的典型特征。在子结构分析中,模型生成的分子具有与真实分子更接近的环结构和键角分布。总之,本文开发了一种更加合理的面向靶点口袋的潜在药物分子设计的神经网络模型。
Abstract
Designing adaptor molecules against protein targets is a challenging task. In recent years, deep generative models have been successfully applied to the molecular design of new drugs. Models that construct molecules from the atomic level are prone to generate structures that do not conform to the chemical laws; the development of molecular design models that are easy to synthesize and have high affinity remains an important part of research in this field. In this paper, we develop a target protein-oriented drug molecular design model, BFMOL. The model consists of two encoders and a gated self-attentive decoder; the encoder is used to extract the features of the target and ligand molecules, and the decoder realizes the association of the two features and decodes them into the probability of the molecular fragments, which then generates the ligand molecules. The model fragments the molecule by BRICS method and characterizes the target at three levels: atom, residue and inter-residue. The results show that on the Crossdocked dataset, the molecules designed by BFMOL have an average synthetic accessibility score of 0.769 and an average druggability score of 0.607, which are higher than the baseline model PMDM (0.611 and 0.594). In the design of molecules against kinase-like targets, the model-generated molecules possessed more double six-membered ring systems with typical features of kinase inhibitors. In substructure analysis, the model-generated molecules have the closest ring structure and bond angle distribution to the real molecules. In conclusion, a more rational neural network model for potential drug molecule design toward target proteins was developed in this work.
Keywords
针对蛋白靶点设计新药分子是一项具有挑战性的任务。以往,基于配体的方法主要依据定量结构活性关系(QSAR),发现更好的药物;分子对接方法通过计算受体与配体的相互作用,识别亲和力更好的分子[1]。这类方法,主要在现有的分子库中发现药物。近年,生成式的人工智能方法可以根据蛋白靶点结构,生成新的分子,有可能发现性能更好的药物[2]。例如,Insilico Medicine公司使用人工智能(AI),设计了一种针对肺部纤维化疾病的小分子药物INS018_055[3],其治疗效果在多项临床试验中得到了验证,该药物是世界上首个完全基于AI技术的药物,展示了AI技术在药物发现中的潜力。
早期的药物分子设计的深度学习模型,主要通过优化生成模型,学习化学空间中现有分子的特性,并以此生成具有理想性质的全新分子[4],实质是一种基于配体特征的生成模型。这类模型中,通常需要将配体分子表示为字串或者图的形式,然后建立学习模型。Gomez-Bombarelli等[5]将小分子以简化分子线性输入规范(SMILES)的形式表示,生成了与训练数据相似的分子,但分子的有效性不足;Jin等[6]则用子图集合来表示,生成的分子全部有效。小分子的另一类表示方法是片段化表示。流行的片段化表示方法有:RECAP[7]、BRICS[8]以及基于SMARTS序列[9]或图[10]等。其中RECAP对化学反应中常见的11种键进行断裂,规则简单,片段集质量较低,容易出现冗余碎片;基于SMARTS序列或图的片段化方法灵活度高,但容易生成化学上不合理或成药性低的片段;BRICS通过药物化学概念定义了16种断裂规则,使得断裂后的片段具有更高的类药性和合成可及性。
仅使用配体特征的模型没有充分应用蛋白质和配体分子之间的相互作用信息,而相互作用信息实质是药物分子发挥作用的关键。因此,有研究者将蛋白靶点的药物口袋信息整合进深度学习模型,用于配体设计。Masuda等[11]提出的LiGAN模型,采取原子密度网格表示靶点口袋,生成以结合位点为条件的 3D 分子结构,提高了生成分子与靶点的结合亲和力;Luo等[12]提出Pocket2mol,通过自回归的方式直接在靶点口袋中采样生成分子,获得了更准确的结果。实际上,靶点口袋包含更丰富的信息,需要更多层面的表示来提取信息。
在模型结构上,呈现多样化的设计。模型LiGAN使用条件变分自编码器(CVAE);Pocket2mol基于等变神经网络;FLAG[13]采用3D图神经网络,以迭代的方式逐基序生成分子;PMDM[14]采用扩散模型,以双重扩散策略逐步生成原子。
综上,现有模型倾向于同时考虑靶点和配体分子的结构特征,在小分子生成中,一般以原子为单位,来填满靶点口袋。其缺陷在于容易生成不符合化学规律的结构,而且,如果在扩散模型的框架下,早期生成的无效结构会产生积累。另外,在靶点口袋表示上,可以在更丰富的层面提取口袋特征,实现最优分子生成。
本文开发了一种基于靶点结构和分子片段的药物设计模型BFMOL。BFMOL在靶点口袋的表征中同时考虑了其在原子、残基和残基间三个层次上的特征信息,并通过BRICS算法[8]构建了分子片段数据集,以BRICS片段为单位设计药物分子。在模型结构上,设计了两个编码器,分别处理靶点口袋特征和药物分子特征;通过一个门控自注意力解码器实现两种特征的关联,解码出分子片段概率,最终生成新的配体分子。由于BRICS算法得到的分子片段均为类药片段,避免了出现无效和不合理的拓扑结构。结果表明,BFMOL生成的分子具有更高的类药性和合成可及性得分。
1 数据
模型使用的数据集为Luo等[12]构建的Crossdocked数据集,该数据集包含183 461对靶点口袋-配体对。本文去除了其中无法被RDkit[15]转换为规范SMILES表示的数据,以及靶点口袋文件中主干原子(N、Cα、C、O)坐标信息不全的数据,最终保留了172 216对靶点口袋-配体对数据,并按照0.7∶0.15∶0.15的比例将数据随机划分为训练集、测试集和验证集。
2 方法
2.1 靶点口袋表征
BFMOL在靶点口袋表征中纳入了更丰富的三维特征信息,相较于只考虑残基序列,可以更全面地表示靶点口袋。对于每个口袋,考虑其在原子、残基和残基间三个层次上的特征:
1)原子级特征:包括原子类型和相对坐标。首先,读取口袋内每个氨基酸残基的四种主干原子(N、Cα、C、O)的原子类型以及坐标信息。然后,计算每个原子对应的四维原子类型独热编码向量,根据坐标信息计算各原子对于同一残基内Cα原子的相对坐标(𝛥𝑥𝑖,Δ𝑦𝑖,Δ𝑧𝑖)(式1):
(1)
其中(𝑥𝑖,𝑦𝑖,𝑧𝑖)代表某个主干原子的坐标,()代表该原子所处残基的Cα原子的坐标。
2)残基特征:包括残基类型和残基主干二面角。首先,计算口袋中每个残基对应的21种残基类型的独热编码向量(包含常见的20种氨基酸残基类型,以及不属于常见残基类型X)。然后,根据所有残基的N、Cα、C三种主干原子的坐标计算靶点骨架的二面角。具体如下:计算相邻主干原子之间的位移向量𝑢(式2-式3):
(2)
(3)
其中,𝑑𝐶𝑖表示相邻主干原子之间的坐标差,𝑢𝑖 为归一化后的 𝑑𝐶𝑖。
获得位移向量 𝑢 后,计算相邻位移向量之间的法向量 𝑛,𝑛 代表每三个相邻原子所形成的平面的法向量(式4):
(4)
根据相邻两个法向量计算两个平面关于公共边的夹角 𝐷(式5):
(5)
将夹角赋予公共边的前一个原子,残基主干上未获得夹角的第一个原子和最后两个原子,夹角以零值代替,每个残基一共获得三个夹角,用于表示其主干的二面角信息。
之后对于每个残基的三个二面角计算正弦值和余弦值,三个二面角的正弦值和余弦值拼接后得到六维的二面角特征向量(式6):
(6)
3)残基间特征:包括残基间距离和残基间相对位置编码。根据四种主干原子的坐标计算残基中心的坐标(式7):
(7)
𝐶𝑖代表第 𝑖 个残基的残基中心坐标,𝑋𝑖𝑗是第 𝑖 个残基中第 𝑗 个原子的坐标。两个残基中心的距离用欧式距离表示(式8):
(8)
相对位置编码是在残基索引差值的基础上,利用Transformer模型[16]中的位置编码公式计算,目的是表示残基之间的相对位置关系。具体为:计算每个残基与其邻居残基的索引差(式9):
(9)
其中,𝑖 代表第 𝑖 个残基在口袋残基序列上的索引值,𝐸𝑖𝑗代表第 𝑖 个残基的第 𝑗 个邻居的索引值。求得索引差后,与频率 𝑓𝑘 做乘积(式10-式11):
(10)
(11)
其中,𝑁emb代表位置编码的维度,𝑘 代表不同位置编码的维度索引。最后通过正余弦函数生成相对位置编码(式12):
(12)
以这种方式计算得到的相对位置编码可以帮助模型学习各残基在口袋残基序列上的相对位置关系。
2.2 靶点口袋图构建
BFMOL将靶点口袋表示为一个𝑘-最近邻(KNN)图(图 1)。图中的每一个节点代表了口袋中的每个残基,每条边代表残基之间的连接,对每个残基只考虑与其最近的 𝑘 个邻居之间的连接(𝑘= 30)。若邻居残基数量不足,则使用虚拟邻居填充,并生成掩码用于标记真实邻居和虚拟邻居,在图神经网络进行消息传递的过程中,通过掩码可以让模型忽略残基的虚拟邻居。
获得残基的特征后,通过如下方式进行特征嵌入(图 1):原子级特征通过线性变换和池化后嵌入。残基特征通过归一化和线性变换后嵌入,并与对应的原子级特征嵌入相加,得到一个复合嵌入,作为蛋白靶点图中节点的特征。残基间特征通过归一化和线性变换后嵌入,作为蛋白靶点图中边的特征。
2.3 配体分子表征
BFMOL以片段为单位进行药物分子设计。本文采用BRICS算法对分子进行片段化处理。BRICS算法对分子片段化的过程为(图 2):按照SMILES表示对应的顺序,从左到右遍历分子中所有可以断裂的化学键,获得符合BRICS断裂规则的化学键的索引。在化学键索引处,迭代断裂分子,在断裂处引入虚拟原子标记(Dummy atom),以虚拟原子标记逆合成完整分子。为了避免过度断裂,BFMOL中断裂的最小片段的原子数目设置为3。若片段原子数小于3则舍弃本次断裂,在下一个可断裂的化学键处重新进行断裂。
对数据集中所有配体分子进行断裂后,过滤掉重复片段,一共获得了10 475种独特的片段,将其转化为SMILES表示并依次定义索引,最终构建得到大小为10 475的BRICS片段数据集。

图
1
靶点口袋特征嵌入流程
Fig.
1
Feature embedding workflow for target binding pockets

图
2
分子片段化及构建片段数据集的流程
Fig.
2
Workflow of molecular fragmentation and fragment dataset construction
得到所有配体分子的片段后,将片段数据转化为片段嵌入。该过程将配体分子的SMILES表示视为句子,将断裂的片段视为词汇。通过Skip-gram模型[17],将每个片段转化为固定维度的词嵌入,这种嵌入方法可以更好地学习到稀有片段,同时在训练过程中保留片段之间的相关性。
2.4 模型结构
BFMOL采用双编码器-解码器结构。编码器包括靶点口袋编码器和分子片段编码器,分别负责提取靶点口袋和分子片段的特征,解码器实现两种特征的关联并解码为分子片段概率,进而生成分子,模型完整结构如图 3所示。

图
3
BFMOL结构示意图
Fig.
3
Schematic structure of BFMOL
2.4.1 靶点口袋编码器
靶点口袋编码器以蛋白靶点图作为输入。首先,图中的节点特征和边特征通过消息传递神经网络(MPNN)[18],进行信息的传递和聚合,优化节点的特征表示。经过MPNN后,靶点口袋表示为一个256维的向量 𝑝。然后,利用变分自编码器(VAE)模型[19],学习靶点口袋的潜在空间分布。对于每个口袋样本 𝑝,计算均值 𝜇 和方差 𝜎²,以及口袋潜在向量 𝑧𝑝 的分布(式13):
(13)
最后,通过添加噪声使分布连续可微(式14):
(14)
其中 是一个从标准正态分布中采样的噪声。
2.4.2 分子片段编码器
分子片段编码器接受每条分子片段序列嵌入𝑥=(𝑥₁,𝑥₂,···,𝑥𝑖)作为输入。对于 𝑥𝑖,通过两个门控循环单元(GRU)[20]转化为隐藏状态 ℎ𝑖=GRU(𝑥𝑖.ℎ𝑖-1),经前向传播后,将最后的隐藏状态 ℎFinal作为片段序列的潜在表示。使用靶点口袋编码器类似的方式,计算分子片段序列的潜在向量 𝑧𝑥 分布(式15-式17):
(15)
(16)
(17)
2.4.3 解码器
解码器由GRU模块和多头自注意力模块组成。其中,GRU模块用来捕捉分子片段序列的顺序信息,即局部依赖;多头自注意力模块用来捕捉分子片段序列的全局依赖。通过这种方式增强模型的表达能力和灵活性。解码过程为:首先,将靶点口袋潜在向量 𝑧𝑝 和分子片段序列潜在向量 𝑧𝑥 相加,得到复合潜在向量 𝑐𝑧,通过线性层将 𝑐𝑧 转换为初始隐藏状态,作为GRU模块的输入,GRU模块输出最终隐藏状态 ℎ𝑐Final。然后,通过多头自注意力模块对 ℎ𝑐Final进行自注意力计算(式18-式19):
(18)
(19)
多头自注意力分数拼接后(式20),用于计算分子片段的概率分布Probs(x)(式21):
(20)
(21)
其中, 为输出全连接层。
2.5 分子生成
分子生成是一个自回归式逐片段的过程。首先,初始化一个零向量,作为起始序列的第一个Token(片段)。两个编码器对起始序列和对应的靶点口袋进行处理后,获得隐藏状态。然后,解码器利用起始序列和隐藏状态,计算分子片段的概率分布,以多项式采样的方式从该分布中采样下一个Token,并利用温度参数(temperature)调节采样过程(式22-式23):
(22)
(23)
其中,𝑥 表示分子片段,Probs(𝑥) 表示分子片段的概率分布,multinomial表示多项式采样。
最后,利用当前片段的序列嵌入和更新后的隐藏状态,再次输入编码器后生成下一个Token,直到解码器生成终止标记EOS或生成的片段序列达到指定的最大长度(8个片段)时,生成过程停止。生成完成后,按照生成的顺序,在片段的虚拟原子处依次进行连接,从而形成一个完整分子的SMILES表示。
2.6 模型训练
训练的损失函数包括重构损失CE和KL散度损失两项(式24-式26)。重构损失CE对输出序列 𝑋′ 和真实序列 𝑋 中每个位置的片段索引值计算交叉熵损失,使解码器生成的序列尽可能接近真实序列;KL散度损失使分子片段编码器生成的潜在变量尽可能符合标准正态分布:
(24)
(25)
(26)
其中,𝑋 和 𝑋′ 分别表示真实分子的片段序列和模型生成的片段序列,𝑥𝑖 和 𝑥′𝑖分别表示 𝑋 和 𝑋′ 中每个位置的片段索引值。
训练过程采用Adam优化器[21],并引入ReduceLROnPlateau学习率调度器[22]自动调整学习率,详细的超参数设置如表 1所示。模型的训练设备为GeForce RTX 4090 GPU,代码通过python3.9、pytorch2.2.1实现。
表
1
BFMOL训练参数设置
Table
1
Training parameter configuration of BFMOL

2.7 评估指标
1)合成可及性(synthetic accessibility(SA)):SA得分越高表示越容易合成,计算方式为(式27):
(27)
其中,fragmentScore来自于PubChem中100万种化合物的ECFP4指纹频率的加权计算,complexityPenalty是分子中非标准结构特征的占比。
2)类药性评分(QED):QED用来评估模型生成的分子与药物的相似度,评分越高代表分子越有可能成为药物,通过RDkit计算得到。
3)高亲和分子比例(High affinity):该比例代表模型预测的分子中,对接得分高于真实分子的分子比例。
4)脂水分配系数(LogP):对于药物分子,LogP一般在-0.4~5.6之间。
5)Lipinski五规则(Lipinski):Lipinski五规则是成药分子的综合特征。
6)对接得分(Vina score(ΔG)):Vina Score由AutoDock Vina软件[24]计算,用于评估药物分子与其蛋白质靶点的结合亲和力,值越低代表药物分子与结合靶点更匹配。
7)多样性(Diversity):用来评估生成分子的多样性,值越高代表模型生成结果更多样,计算方式为(式28):
(28)
其中Tanimoto代表成对分子的平均Tanimoto相似度。
3 结果
3.1 靶点口袋特征的消融实验
理论上,有效的口袋表征方式会让模型更好地学习到不同口袋之间的差异,从而更有针对性地生成配体分子。消融实验在3.7节说明的100个靶点口袋上进行,对每个靶点口袋设计100个药物分子。计算各种特征逐步纳入模型后,生成的所有药物分子与对应靶点的平均分子对接得分(Vina score)。
六种靶点口袋特征的消融实验结果见表2。在只考虑残基类型的基础上,每纳入一种新的特征信息,都在一定程度上提高了模型生成结果的对接得分,纳入所有特征信息后,模型取得了最好的结果。从对接得分的变化看,残基主干二面角、残基原子类型、残基间距离的特征对模型贡献较大(> 8%)。该结果表明:与仅考虑残基类型的表征方法相比,本文设计的新的靶点口袋表征方法可以有效提升模型的学习能力。
表
2
靶点口袋特征的消融实验
Table
2
Ablation study on target binding pocket features

注:“√”代表考虑此种特征,“-”代表不考虑此种特征.
3.2 生成药物分子的评估
选取了4种模型与基线模型进行比较,这四种模型是LiGAN[11]、Pocket2Mol[12]、FLAG[13]和PMDM[14]。所有模型使用2.7节说明的100个靶点口袋进行比较,超参数使用各模型的最优参数进行配置。在生成测试时,LiGAN使用先验采样方式,Pocket2mol在采样时启用初始掩码,FLAG设定基序提取阈值为100,PMDM启用掩码策略和数据增强。
各模型的评估结果见表3。BFMOL设计的分子,合成可及性(SA)、类药性(QED)和多样性得分(Diversity)优于其他基线模型,也优于测试集中的分子(真实分子),分别达到0.769、0.607和0.815。在高亲和分子比例(High affinity)和对接得分(Vina score)上,BFMOL略低于FLAG和PMDM,但优于LiGAN、Pocket2Mol和测试集分子,分别达到0.562和-7.236。在Lipinski五规则得分(Lipinski)上,BFMOL略低于Pocket2mol、FLAG和PMDM,高于LiGAN和测试集分子,达到4.824。总体上,BFMOL性能优良。
表
3
测试集及不同模型生成的分子的评估结果
Table
3
Evaluation results of the test set and molecules generated by different models

注:粗体为不同模型中最优者.
3.3 生成案例分析
3.3.1 针对特定靶点的生成案例分析
选择了三个靶点进行分子设计,分别是:p21 活化激酶 4(PAK4,PDB id:5I0B)、泛素结合酶(Ube2T,PDB id:5NGZ)和前列环素合酶(PGIS,PDB id:3B6H)。其中,PAK4突变在多种肿瘤中被检测到[25];Ube2T的过表达与肺腺癌、胃癌和卵巢癌等多种恶性肿瘤的发展有关[26];PGIS在多种疾病中其表达发生了改变[27]。对这三个靶点,分别使用FLAG,PMDM和BFMOL,设计100个配体分子。然后,计算其中对接得分前5的分子的平均合成可及性、类药性和Lipinski五规则得分。
由图4可以看出,在5I0B和3B6H两个靶点中,FLAG设计的分子具有八元环和七元环结构;在三个靶点中,PMDM设计的分子,均出现四个以上的稠环,这些结构在真实药物分子中出现频率不高,合成难度较大。BFMOL设计的分子,其合成可及性和类药性更好(图4、表4)。
表4中,BFMOL设计的15个分子全部符合Lipinski五规则,优于FLAG和PMDM。针对靶点5I0B和3B6H,BFMOL设计的分子具有最高的合成可及性得分;针对靶点5I0B和5NGZ,BFMOL生成的分子具有最高的类药性得分。BFMOL设计的分子,在对接得分上略低于PMDM模型,但依然高于真实分子。综上,BFMOL能设计出容易合成、具备成药潜质的药物分子。
3.3.2 针对激酶类靶点的生成案例分析
激酶是多种癌症的治疗靶点。激酶抑制剂通常具有化学支架结构,与激酶铰链骨架结合。这些化学支架包括:双六元环结构(如喹啉)、五元环-六元环稠环结构(如嘌呤)、以及氨基嘧啶等[28]。本文选取了三种激酶类,作为靶点进行分子设计。分别是:NF-κB诱导激酶(NIK,PDB id:4G3D)、G蛋白偶联受体激酶4(GRK4,PDB id:4YHJ)和TANK结合激酶1(TBK1,PDB id:4IWQ)。其中,NIK的异常表达与多种炎症和癌症相关[29];GRK4与高血压的发病机制密切相关[30];TBK1的异常激活与多种癌症的发生密切相关,如肺癌、胰腺癌和结直肠癌等[31]。

图
4
不同模型对特定靶点口袋的配体分子生成案例
Fig.
4
Cases of ligand molecule generation for specific target pockets by different models
注:(a) 针对5I0B靶点的设计结果;(b) 针对5NGZ靶点的设计结果;(c) 针对3B6H靶点的设计结果,粗体为各分子中的最优参数.
表
4
不同模型对特定靶点口袋生成的配体分子的指标比较
Table
4
Comparison of indicators of ligand molecules generated by different models for specific target pockets

注:所列为各模型分子在分子对接中得分前5的分子的指标,粗体为三种模型中最优者.
对每种模型生成的配体分子,使用BRICS方法进行片段化,提取出现频次最高的前五类片段,与激酶抑制剂通常具有的化学支架进行比较,用以评估模型的有效性。结果显示(图 5):针对激酶类靶点,BFMOL更倾向于设计出双六元环系统,即激酶抑制剂的典型结构特征之一,而其他两种方法,尤其是PMDM,这种倾向并不明显。
3.4 生成药物分子的子结构分析
分析了测试集以及FLAG、PMDM和BFMOL生成的分子中,不同环结构的分布比例,计算方法为:不同环结构在分子集中出现的总次数与分子数量的比值。按照Luo等[12]的假设,即使由不同方法生成的分子,结构和测试集分子不同,两者基本的功能群和子结构的分布应该接近。
由表5的结果可以看出,FLAG方法生成的分子中,出现了更多的小环结构如三元环,而PMDM则生成了过量的大环如七元环,这些小环和大环在测试集的真实分子中出现的比例均不高。而由BFMOL生成的分子,其环结构多为五元环和六元环,从整体上看,具有与测试集分子最为相似的环结构分布。
表
5
测试集以及不同模型生成的分子中不同大小环的平均分布比例
Table
5
Comparative distribution of ring size populations of test set and the molecules generated by different models

注:与测试集分子偏差最大的比例用粗斜体表示.

图
5
针对三种激酶靶点的案例分析
Fig.
5
Case studies on three kinase targets
注:(a) 三种激酶靶点对应参考分子的结构;(b) 各方法对三种靶点的设计结果中,频率前五的分子片段.
此外,计算了由每种方法生成的分子中,常见键长和键角的分布,并利用KL散度分析了上述分布与测试集分子分布的相似程度。结果如图6、表6、表7所示:在键长分布方面,BFMOL产生的分子在CC和O=P键的分布上最接近测试集真实分子的分布,而在六种最常见键角的分布上,BFMOL产生的分子的分布均最接近真实分子的分布,优于其他模型。说明BFMOL设计出的分子具有与真实分子更相似的子结构。

图
6
不同模型生成的分子与参考分子的键长和键角分布图
Fig.
6
Distribution of bond lengths and bond angles of the molecules generated by different models and the reference molecules
注:(a)不同方法生成的分子与参考分子的键长分布图;(b)不同方法生成的分子与参考分子的键角分布图.其中“:”代表芳香键,其它原子之间均为单键.
表
6
不同模型生成的分子与参考分子的键长分布的KL散度
Table
6
KL divergence for bond length distributions of the molecules generated by different models andthe reference molecules

表
7
不同模型生成的分子与参考分子的键角分布的KL散度
Table
7
KL divergence for bond angle distributions of the molecules generated by different models andthe reference molecules
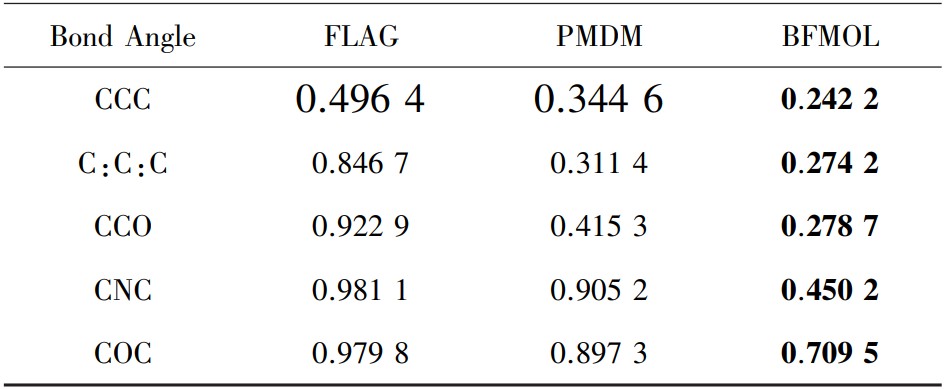
注:最好的结果用黑色粗体表示.
4 总结与讨论
本文开发了一个基于靶点结构和分子片段的药物分子设计神经网络模型,BFMOL;通过BRICS方法对分子进行片段化,并在原子、残基和残基间三个层次对靶点进行特征化;设计了两个编码器,分别用于提取靶点和配体分子的特征,一个门控自注意力解码器实现两种特征的关联并解码为分子片段概率,并最终生成配体分子。
结果表明,BFMOL设计的分子,平均合成可及性得分达到0.769,平均类药性得分达到0.607,高于模型PMDM(0.611和0.594)。在针对激酶类靶点的案例研究中,BFMOL设计的分子具备更多双六元环结构,即激酶抑制剂的典型特征之一。此外,在子结构分析中,BFMOL设计的分子,环结构分布和键角分布也更接近真实分子。同时,本文也发现,BFMOL设计的分子,对接得分略低于其他模型如FLAG和PMDM,这可能是因为后者倾向于设计出更大的分子。总体而言,BFMOL在各类评估中相对优秀。
BFMOL也存在一些可以改进的地方。首先,在使用BRICS方法对分子进行片段化时,不足一半的片段,其出现频率占全部片段的九成以上,部分稀有片段则只在极少数药物分子中出现,这使得模型在设计分子时更倾向于预测高频片段。让模型更好地学习到不均匀的片段分布是未来改进工作的方向之一。此外,BRICS的拆分策略相对固定,容易导致对复杂取代基等结构的错误拆分,需要加入自定义的规则以提高其灵活性。最后,优化的模型结构依然需要进一步探索。
